Journal d’une refonte, épisode 2 sur 4.
Traduire son code ligne à ligne, le meilleur moyen de tout rater…
Dans l’épisode précédent, nous racontions pourquoi nous avions annulé notre propre choix de stack à mi-parcours, et pourquoi nous étions revenus à R. Si vous ne l’avez pas lu, pas de panique : celui-ci se suffit à lui-même.
Aujourd’hui, on parle du portage. Et surtout de la façon dont je l’ai raté la première fois.
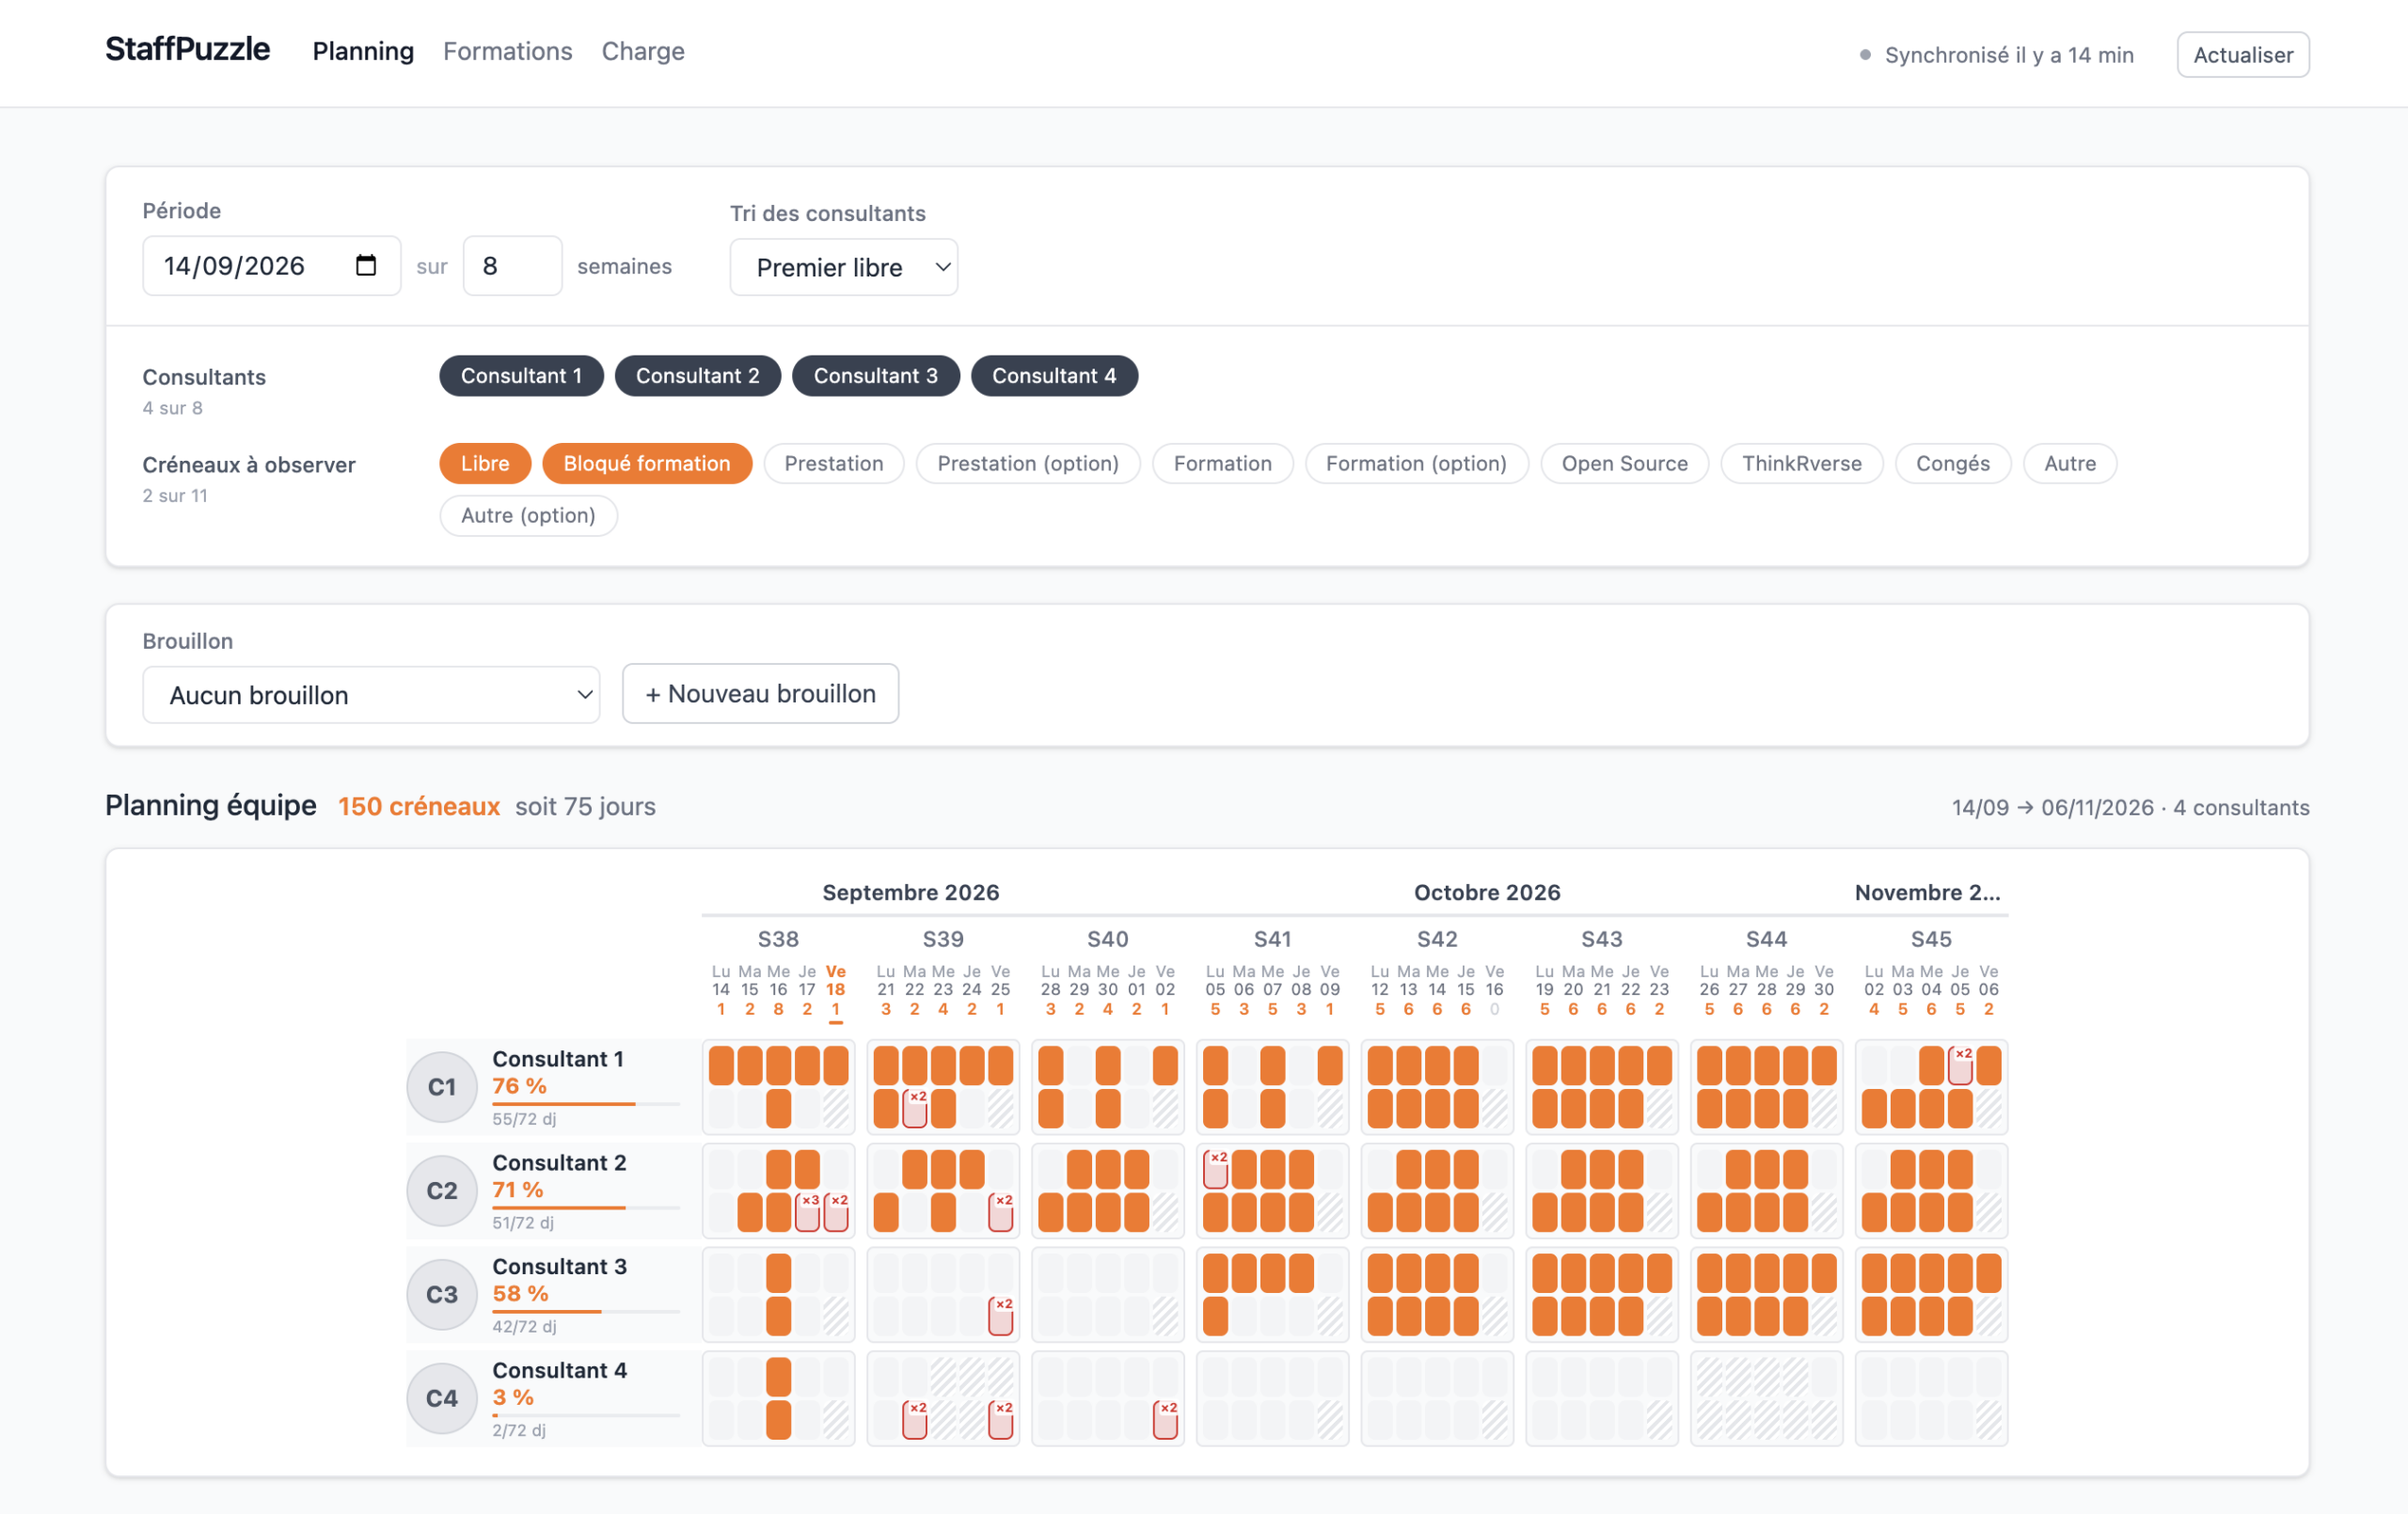
Petit rappel du contexte. StaffPuzzle est notre outil de staffing interne : il dit qui travaille sur quoi, demi-journée par demi-journée. Sa version Shiny fait 1 200 lignes, lit les agendas Google de l’équipe, et tourne depuis des années. L’objectif était de la réécrire en htmxr, c’est-à-dire du HTML rendu côté serveur, hydraté par htmx, avec plumber2 derrière.
Voici comment je m’y suis pris.
J’ai ouvert app_server.R, j’ai listé tous les observeEvent, et j’ai commencé à en faire des routes. Une route par observer. C’est méthodique, c’est exhaustif… et ça produit une application pleine d’endpoints qui ne servent à rien.
Pour rappel, une route, c’est quoi ? Dans une application web classique, le navigateur demande une adresse et le serveur lui renvoie une réponse. Une route, c’est ce couple : une adresse, et la fonction qui fabrique ce qu’on renvoie. Là où Shiny tient une conversation continue avec le navigateur pendant toute la visite, une application à routes répond à des demandes indépendantes les unes des autres, sans se souvenir de la précédente.
Concrètement, voici le genre de traduction que je faisais. Côté Shiny, l’observer qui reconstruit le graphe principal dès qu’un filtre bouge (je l’ai raccourci et renommé pour la lisibilité, l’original est plus touffu) :
observeEvent(c(input$refresh, rv$slots, rv$data_ready), {
  req(rv$slots, rv$consultants, rv$start, rv$end, rv$sort_by)
  rv$filtered_slots <- rv$slots |>
    filter(member %in% rv$consultants) |>
    mark_focus(types = rv$slot_types) |>
    add_weekdays()
  rv$plot <- rv$filtered_slots |>
    team_availability_plot(
      start   = rv$start,
      end     = rv$end,
      sort_by = rv$sort_by,
      order   = rv$consultants
    )
})
Et, cent lignes plus bas dans le même fichier, la sortie qui l’affiche :
output$plot <- renderPlotly({
  rv$plot |> ggplotly(tooltip = "text")
})
Côté routes, ça devient une adresse et une fonction :
#* @get /plot
function(consultants, start, end, sort_by, slot_types) {
  slots |>
    filter(member %in% consultants) |>
    mark_focus(types = slot_types) |>
    add_weekdays() |>
    team_availability_plot(
      start   = start,
      end     = end,
      sort_by = sort_by,
      order   = consultants
    )
}
Le navigateur demandera /plot?consultants=arthur,vincent&start=2026-10-05&end=2026-11-30&sort_by=alphabetical, et le serveur répondra par le morceau de page correspondant.
Voyez au passage ce qui a fondu côté Shiny : il me faut un observer, un emplacement dans reactiveValues pour y ranger le résultat, et un render* ailleurs dans le fichier pour l’afficher. Côté route, il ne reste qu’une fonction qui prend des arguments et rend quelque chose. Celui-là se traduit bien : il produit quelque chose de visible, et ce quelque chose peut dire son adresse.
Le problème, c’est tous les autres.
Mon erreur ne venait pas d’une méconnaissance de l’outil d’arrivée. Je traduisais du code au lieu de changer de paradigme. Et il m’a fallu plusieurs jours pour m’en rendre compte !
C’est un peu comme un déménagement. On ne prépare pas ses cartons en photographiant chaque pièce pour la reconstruire à l’identique dans le nouvel appartement. On regarde ce dont on se sert vraiment, et on laisse le reste au vide-grenier.
Voici donc ce que j’aurais aimé qu’on me dise avant de commencer.
Pourquoi l’inventaire des observers est le mauvais point d’entrée
Table des matières
La raison est structurelle. Shiny est piloté par un graphe réactif, et une bonne part des observers n’a aucune sortie visible. Ils recopient une valeur d’un endroit à un autre, ils désactivent un bouton, ils tiennent deux inputs synchronisés. Bref, ils maintiennent la cohérence d’un état en mémoire.
Or cet état n’existe pas en htmxr. Le travail de ces observers non plus. Ils ne se traduisent pas : ils disparaissent.
Je me souviens de la phrase que j’ai lâchée en réunion, le 30 juin, au beau milieu du portage :
J’ai le sentiment que dire « j’ai tel ou tel observeEvent, j’ai donc tel ou tel endpoint », c’est pas ok. Par contre, j’ai pensé que partir de la data à servir est un bon point d’entrée.
C’est resté ma règle de travail depuis.
Partir de la donnée servie
Une application htmxr, c’est un ensemble de blocs de données adressables. Chaque bloc affiché a une URL qui le rend. Les contrôles qui le pilotent (filtres, dates, tri) sont les paramètres de cette URL. On est dans un cadre hypermédia, plus dans un graphe de dépendances.
La méthode tient en 5 gestes, et l’ordre compte :
- Inventoriez les écrans, capture par capture. Pas ce que fait le code : ce que voit l’utilisateur.
- Découpez chaque écran en blocs de données : en-tête, filtres, grille, panneau de détail.
- Donnez une URL à chaque bloc. Un bloc incapable de dire son adresse est un bloc mal découpé.
- Transformez les contrôles en paramètres.
?start=2026-10-01&n_weeks=8, et non des observers. - Pour chaque interaction, posez-vous une seule question : est-ce une mutation d’état métier persistant ?
C’est la cinquième que je ratais systématiquement. Cliquer sur un filtre, changer un tri, choisir une période : ce sont des GET, même si « ça change quelque chose » à l’écran. Rien n’est modifié côté serveur, on demande simplement une autre vue des mêmes données.
Tips : si votre inventaire produit beaucoup de POST, c’est probablement que des GET s’y sont glissés. Repassez-les en revue.
60 lignes qui n’ont plus d’objet
Voici l’exemple qui a fait basculer ma compréhension.
Ma version Shiny consacrait 60 lignes à tenir l’URL et les inputs synchronisés dans les deux sens. Du bon code, d’ailleurs : cette application avait des URL partageables, ce qui n’est pas si courant en Shiny.
Côté Shiny, 60 lignes. En voici les deux extrémités, abrégées et renommées :
## Direction 1: the URL arrives, we put the inputs in the right state
observeEvent(session$clientData$url_search, {
  params <- parseQueryString(session$clientData$url_search)
  url_params$consultants <- params$consultants
  url_params$slot_types  <- params$types
  url_params$services    <- params$services
  url_params$period      <- params$period
  if (!is.null(url_params$consultants)) {
    updateSelectInput(
      session  = session,
      inputId  = "consultants",
      selected = str_to_title(
        str_split_1(str_remove_all(url_params$consultants, " "), pattern = ",")
      )
    )
  }
  ## … and the same treatment for period, slot_types and services
})
## Direction 2: an input moves, we rewrite the URL
observeEvent(
  c(input$consultants, input$slot_types, input$services,
    input$period, input$sort_by),
  ignoreInit = TRUE, {
    consultants <- str_to_lower(glue_collapse(input$consultants, sep = ","))
    slot_types  <- str_to_lower(glue_collapse(input$slot_types, sep = ","))
    period      <- glue_collapse(input$period, sep = ",")
    url <- glue("?consultants={consultants}&types={slot_types}&period={period}")
    updateQueryString(session = session, url, mode = "replace")
  })
Côté htmxr, un argument :
hx_set(
  form,
  get      = ".",
  target   = "#trainings-view",
  trigger  = "change",
  push_url = "true"
)
Attention, il ne s’agit pas d’une affaire de concision. Ces 60 lignes n’ont pas été raccourcies : elles n’ont plus d’objet. Elles maintenaient un miroir entre deux représentations du même état, l’URL d’un côté, les inputs de l’autre. Quand l’URL est l’état, il n’y a tout simplement plus de miroir à tenir.
Reprenons notre déménagement : ce ne sont pas des meubles qu’on remonte dans le nouvel appartement. Il n’y a pas la pièce pour.
Vous voulez un test simple pour savoir où vous en êtes ? Si votre portage produit du code qui synchronise deux choses, c’est que vous avez gardé le paradigme d’origine. Un bon portage supprime des catégories entières de code, il ne les réécrit pas plus court.
Ce qui arrive à chaque brique
Une fois le cadre posé, le portage devient mécanique. Voyons ce que deviennent les briques que vous avez sous les yeux dans votre server.R.
Un module devient une route et une fonction de rendu. Mon plus gros module faisait 267 lignes : 4 selectInput, un dateRangeInput, 6 observers, et la synchronisation d’URL. Il n’en reste qu’un formulaire HTML et des paramètres. Le ns() disparaît entièrement, puisqu’il n’existait que pour éviter les collisions d’identifiants entre instances. Sans liaison d’inputs, il n’y a plus rien à nommer.
input$x devient un argument de votre fonction. Il n’y a plus d’objet input. La valeur arrive dans la requête : en paramètre d’URL pour un GET, dans le corps pour un POST. C’est le changement le plus déroutant les premiers jours, et le plus libérateur ensuite. Une fonction de vue reçoit ses entrées en argument, donc elle se teste !
output$x <- render*() devient une fonction qui rend du HTML. Le couple output/render disparaît. Il ne reste qu’une fonction et sa valeur de retour, appelée par une route. Un renderPlot devient une URL qui sert le SVG, un renderUI une URL qui sert un fragment.
updateSelectInput() devient : rien. On ne met plus un contrôle à jour. Le serveur rend le <select> dans l’état où il doit être, et htmx remplace le fragment qui le contient. Toute la famille des update*Input() s’évapore avec.
invalidateLater() devient un attribut. Un rafraîchissement périodique s’écrit trigger = "every 15s". Le navigateur redemande le fragment, le serveur le recalcule. Aucun état à invalider, puisqu’il n’y en a pas.
showNotification() et withProgress() deviennent un fragment, ou du CSS. Un message est un bout de HTML renvoyé avec la réponse. Un indicateur d’attente est un élément que htmx montre pendant la requête et cache après. Une classe CSS, et non du code R.
reactiveValues() et session$userData deviennent l’URL, ou la base. Dans l’URL si ça décrit ce qu’on regarde, en base si ça doit survivre à la fermeture de l’onglet. Et s’il ne reste rien après ce tri ? C’est que c’était de l’état de plomberie, et il part avec le reste 😉
Le voir tourner
Tout ça reste abstrait tant qu’on ne l’a pas sous les yeux. Alors prenons l’exemple canonique de Shiny, celui que vous obtenez avec shiny::runExample("01_hello") : l’histogramme du geyser Old Faithful, avec un curseur pour le nombre de classes.
- L’application, écrite en htmxr. Un curseur, un graphique, et c’est tout.
- L’URL qui sert le graphique. Ouvrez-la directement dans votre navigateur : vous tombez sur le SVG lui-même, le dessin en toutes lettres. C’est exactement ce que veut dire « donner une URL à chaque bloc ».
Amusez-vous à changer bins=30 en bins=5, puis en bins=50. Le serveur recalcule et vous renvoie le dessin. Aucune session, aucun état, aucune conversation ouverte.
Et le code, des deux côtés
La version Shiny, vous la connaissez : c’est celle du tutoriel. La voici réduite à l’essentiel.
ui <- page_sidebar(
  title = "Hello Shiny!",
  sidebar = sidebar(
    sliderInput("bins", "Number of bins:", min = 1, max = 50, value = 30)
  ),
  plotOutput("distPlot")
)
server <- function(input, output) {
  output$distPlot <- renderPlot({
    x    <- faithful$waiting
    bins <- seq(min(x), max(x), length.out = input$bins + 1)
    hist(x, breaks = bins, col = "darkgray", border = "white")
  })
}
Et la version htmxr, celle qui tourne derrière le lien ci-dessus. J’ai retiré les classes Bootstrap, elles n’apprennent rien.
#* @get /
#* @serializer html
function() {
  hx_page(
    hx_head(title = "Old Faithful Geyser Data"),
    hx_slider_input(
      id      = "bins",
      label   = "Number of bins:",
      value   = 30, min = 1, max = 50,
      get     = "plot",
      trigger = "input changed delay:300ms",
      target  = "#plot"
    ),
    tags$div(id = "plot") |>
      hx_set(get = "plot", trigger = "load", target = "#plot")
  )
}
#* @get /plot
#* @serializer none
function(query) {
  xmlSVG({
    x    <- faithful$waiting
    bins <- seq(min(x), max(x), length.out = as.numeric(query$bins %||% 30) + 1)
    hist(x, breaks = bins, col = "darkgray", border = "white")
  }, width = 7, height = 5)
}
Trois choses à regarder, et elles résument tout l’article.
Le curseur est le même objet. sliderInput(id, label, min, max, value) devient hx_slider_input(id, label, min, max, value). Il n’y a rien à réapprendre.
Le calcul du graphique n’a pas bougé d’une ligne. Les quatre lignes de hist() sont identiques des deux côtés. C’est ce que je n’avais pas compris en commençant : ce n’est pas votre code métier que vous portez, c’est la plomberie autour.
Ce qui change, c’est le câblage, et il devient visible. En Shiny, rien ne dit que bouger le curseur redessine le graphique : le graphe réactif le déduit tout seul de la présence d’input$bins dans le renderPlot. En htmxr, c’est écrit sur le curseur lui-même : get = "plot" (va chercher cette adresse), target = "#plot" (mets le résultat là). Vous lisez le branchement au lieu de le deviner.
Et le server <- function(input, output) a disparu. Il ne reste que deux fonctions qui prennent des arguments et rendent quelque chose.
L’essayer chez vous
Inutile de recopier quoi que ce soit : l’exemple est livré avec le paquet.
# install.packages("pak")
pak::pak("hyperverse-r/htmxr")
htmxr::hx_run_example("hello")
Votre navigateur vous attend sur http://127.0.0.1:8080. Bougez le curseur : chaque mouvement part en requête vers /plot, et le serveur renvoie un nouveau SVG. Ouvrez l’onglet réseau de votre navigateur pour les regarder passer, c’est plus parlant que n’importe quelle explication.
Et si vous appelez hx_run_example() sans argument, il vous liste les autres : select-input, multi-select, delete-row, toast-notification, infinity-scroll, page-or-fragment, json-endpoint et reactive-values. Ce dernier vaut le détour si vous vous demandez ce que devient un reactiveValues() une fois le graphe réactif parti.
Et puisque le graphique est une URL, n’importe qui peut le consommer. Voici la même application écrite en React, qui appelle exactement le même endpoint R. Le backend ne sait pas qui l’interroge, et il s’en moque.
C’est la propriété la plus sous-estimée du découpage en blocs adressables : il ne vous enferme pas. Le jour où vous voulez un autre frontend, ou une application mobile, ou simplement qu’un collègue récupère votre graphique dans son propre outil, votre logique R est déjà une API. Elle l’est devenue sans que vous ayez rien fait de plus.
Ce qui coûte, et ce qui ne coûte pas
Tout ce qui précède est mécanique. Sur mon portage, 3 patterns seulement ont demandé une vraie décision, et ce sont eux qui font varier une estimation.
| Pattern Shiny | Coût | Équivalent |
|---|---|---|
selectInput, actionButton, sliderInput |
faible | hx_select_input(), hx_button(), hx_slider_input() |
dateRangeInput |
faible | pas de constructeur dédié : deux <input type="date"> |
| sync URL ↔︎ inputs | faible | l’argument push_url |
ggplot statique |
faible | svglite + remplacement htmx |
DT (affichage) |
faible | hx_table(), hx_table_rows() |
| tâche longue + notifications | moyen | job externe + interrogation périodique |
plotly interactif |
élevé | plotly.js, ou abandon de l’interactivité |
rhandsontable |
élevé | bibliothèque JS, ou formulaire par cellule |
La table éditable n’a pas d’équivalent natif. Soit vous embarquez une bibliothèque JavaScript, soit vous reconstruisez en champs HTML avec un enregistrement par cellule. Le critère est dimensionnel : sous une vingtaine de lignes le HTML gagne, sur un millier avec du copier-coller multi-cellules la bibliothèque redevient le bon choix.
Le graphique interactif mérite une question préalable, et c’est justement celle que j’ai oublié de me poser : est-ce vraiment un graphique ? Quand il s’agit en réalité d’une grille de données, d’un planning, d’un calendrier ou d’une carte de chaleur, le porter comme un graphique est une erreur. Le mien en était un parce que Shiny rendait le tableau difficile, pas parce que le tableau était le bon objet. Un vrai graphique, lui, reste un SVG servi par une URL, et c’est un cas facile.
Une dépendance interne opaque ne se contourne pas, elle s’isole. Vous en avez forcément une : le paquet maison qui va chercher les données quelque part, que plus personne n’a vraiment relu depuis des années. La tentation est de commencer par lui, pour « comprendre avant de porter ». Ne le faites pas. Vous y passerez trois jours et vous n’aurez rien porté.
Développez tout le reste sur un jeu de données de démonstration, en dur, et ne branchez le vrai paquet qu’à la toute fin, en une seule fois. À ce moment-là vous saurez exactement ce que vous attendez de lui : une fonction, des arguments, un tableau en retour. Et s’il reste incompréhensible, appelez-le tel quel sans chercher à le réécrire. Ce n’est pas de la lâcheté, c’est ce qui l’empêche de bloquer tout le portage.
L’effet de bord le plus utile
Shiny pousse à mélanger logique métier et orchestration réactive : elles vivent dans le même fichier, souvent dans la même fonction. Dans ma v1, la règle qui décide si un créneau est mis en évidence était calculée deux fois, avec des règles différentes, à 15 lignes d’intervalle. Ce n’était pas de la négligence de ma part, c’est ce que produit un fichier où le métier et la plomberie cohabitent.
Le portage force la séparation. Une fonction appelée par une route ne peut plus s’appuyer sur un contexte réactif ambiant. Ce qui reste est donc du R ordinaire, qui prend des données et rend des données ou du HTML. Donc qui se teste.
Le ratio tests sur code est passé de 0,26 à 0,77 : 544 tests, aucun navigateur, quelques millisecondes. L’interface étant devenue une fonction pure de données vers du HTML, elle tombe dans le même harnais de tests que le reste. L’équivalent Shiny demande shinytest2, un Chrome sans affichage et des instantanés. C’est lent, c’est fragile, et ça casse quand une marge bouge.
Deux honnêtetés s’imposent ici. Ma nouvelle version fait davantage que l’ancienne (écriture dans les agendas, mode brouillon, indicateurs historisés), et une part de l’écart de volume vient de là, pas du paradigme. Et rien n’empêche de tester la logique métier d’une application Shiny : la v1 le faisait sur 300 lignes. Ce qui change, c’est que l’interface cesse d’être la zone qu’on ne teste jamais.
Ce qu’on ne récupère pas
Soyons clairs : le graphe réactif rend un vrai service quand tout dépend de tout. Pensez à un tableau de bord où 6 graphiques liés se recalculent ensemble, avec des dépendances croisées et du dérivé coûteux. Le reconstruire à coups de fragments et de paramètres d’URL est possible, mais on réécrit à la main ce que Shiny nous donne gratuitement.
D’où le seul critère de décision qui vaille, à mon sens : est-ce que l’état de mon application tient dans une URL ?
Pour la mienne, oui : une période, des filtres, un tri. Le portage était donc un bon pari. Pour un outil d’exploration où l’utilisateur construit une session de travail complexe, la réponse est non, et Shiny reste le bon outil. Ce n’est pas une concession de politesse, c’est le même raisonnement appliqué à un autre problème.
Conclusion
Je continue d’écrire du Shiny, pour nos clients et pour nous. Ce portage n’a pas prouvé qu’une technologie battait l’autre.
En revanche, il m’a montré que j’avais, pendant des années, résolu un problème de rendu de pages avec un outil conçu pour tenir un état en mémoire. Et que le coût de cet écart restait invisible tant que je ne l’avais pas payé une fois.
Alors avant de vous lancer, posez-vous la question de l’URL. Elle vous fera gagner les quelques jours que j’ai perdus !
Vous avez une application Shiny dans ce cas ? Nous la lisons et nous vous rendons une note qui dit si le portage vaut le coup, y compris quand la réponse est non. Écrivez-nous en deux lignes : la taille de votre application, et depuis combien de temps elle tourne.
Vous pouvez également retrouver toutes nos formations pour découvrir le développement d’applications Shiny juste ici !
La semaine prochaine, épisode 3 : ce que nous a coûté la sortie de la plateforme managée, facture à l’appui.
Journal d’une refonte, quatre épisodes :
- Nous avons choisi React pour apprendre. L’IA a écrit le code à notre place.
- Ma première tentative de portage Shiny a échoué, et pas pour une raison technique (vous êtes ici)
- On a quitté la plateforme managée. Voilà la facture réelle. (6 octobre)
- Cinq signes que votre app Shiny a dépassé Shiny (13 octobre)
L’application citée est StaffPuzzle, l’outil de staffing interne de ThinkR, écrit avec htmxr, alpiner et plumber2. Les chiffres sont mesurés sur les deux branches du dépôt, pas estimés. Divulgation d’intérêt : je suis l’auteur d’htmxr et d’alpiner.